Lokaler Wissensagent für einen Maschinenbauer mit drei Standorten

Servicewissen aus drei Standorten durchsuchbar, ohne dass ein Dokument das Haus verlässt

Womit wir angefangen haben

Das Unternehmen baut Sondermaschinen und beschäftigt gut 250 Mitarbeiter an drei Standorten. Über zwanzig Jahre ist das Wissen aus dem Service gewachsen: gescannte Serviceberichte, Prüfprotokolle, Änderungsmitteilungen und interne Vermerke, abgelegt an dem Standort, der das Projekt betreut hat. Wer eine Störung schon einmal gesehen hatte, wusste das oft. Alle anderen fingen von vorn an. Cloud-Werkzeuge schieden aus, weil Kunden die Weitergabe von Konstruktions- und Prozessdaten an Dritte vertraglich ausschließen. Offen war, ob sich ein brauchbarer Wissensagent überhaupt komplett im Haus betreiben lässt.

Wie das Projekt gelaufen ist

  1. Anforderungsaufnahme unter Geheimhaltung

    2,5 Wochen

    Vor Ort und ohne Datenabfluss haben wir mit vier Teams aus Service, Konstruktion und Vertrieb die typischen Recherchefragen aufgenommen. Daraus entstanden die Anforderungen an Suche und Nachvollziehbarkeit.

  2. Auswahl und Test lokaler Modelle

    2 Wochen

    Wir haben drei offene Modelle an echten, freigegebenen Serviceberichten verglichen statt an Benchmarks. Den Ausschlag gab, wie genau die Antworten bei den Belegen blieben, der Sprachstil spielte kaum eine Rolle.

  3. Aufbau der Serverumgebung

    2 Wochen

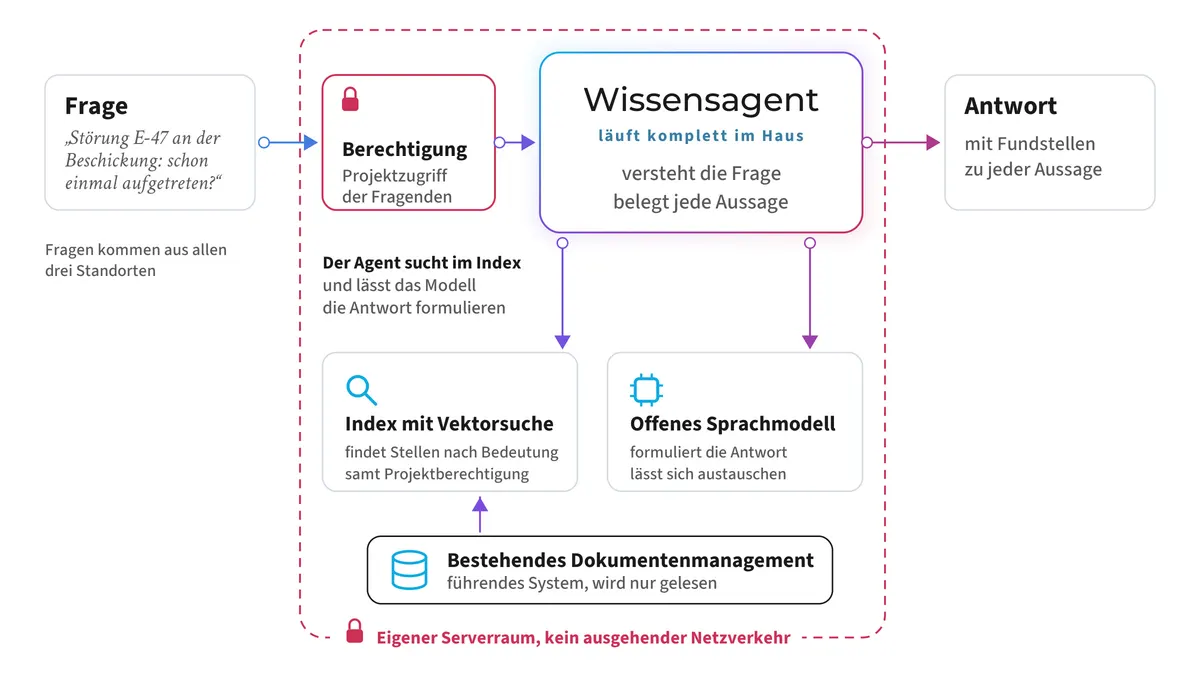
    Zwei Server im Serverraum des Hauptwerks, Modell und Vektorsuche auf derselben Hardware. Die Firewall lässt keinen ausgehenden Verkehr zu, Updates spielen wir über eine getrennte Schleuse ein.

  4. Indexierung der Dokumentenbestände

    5 Wochen

    Rund 210.000 Seiten aus allen drei Standorten wurden erschlossen, ältere Scans per Texterkennung. Jedes Dokument hat dabei die Projektberechtigung aus dem Dokumentenmanagement mitbekommen.

  5. Schulung und Übergabe

    2 Tage

    Zwei Halbtage für die Teams, ein Tag für die IT. Seitdem pflegt der Betrieb den Index selbst, wir sind nur noch für Modellwechsel im Haus.

Was wir gebaut haben

Der Wissensagent läuft ausschließlich auf der Serverinfrastruktur des Maschinenbauers und kommt ohne einen einzigen externen API-Aufruf aus. Ein offenes Sprachmodell und die Vektorsuche liegen auf derselben Hardware, das bestehende Dokumentenmanagement bleibt das führende System und wird nur gelesen. Jede Antwort nennt ihre Fundstellen und beachtet die Projektberechtigung der Fragenden: Wer ein Kundenprojekt nicht einsehen darf, bekommt daraus auch nichts zitiert. Umgesetzt haben wir das in zwölf Wochen, mit einem Wartungsweg, den die eigene IT gehen kann. Das Modell lässt sich tauschen, der Index bleibt bestehen, wenn in einem Jahr ein besseres Modell verfügbar ist.

Was dabei herausgekommen ist

Steht ein Servicetechniker vor einer Störung, die er nicht kennt, fragt er den Wissensagenten. Nach knapp zwanzig Sekunden hat er eine Antwort mit Fundstellen: frühere Serviceberichte, Prüfprotokolle und Änderungsmitteilungen, auch von den beiden anderen Standorten. Früher dauerte so eine Recherche rund 35 Minuten Telefonieren und Suchen. Erschlossen sind etwa 210.000 Seiten, und wer ein Kundenprojekt nicht einsehen darf, bekommt daraus nichts zitiert. Alles läuft im eigenen Serverraum, kein Dokument verlässt das Haus. Über vier Jahre kostet die Lösung gut ein Drittel weniger als das Cloud-Angebot, das die Geschäftsführung als Vergleich eingeholt hatte. Die eigene IT pflegt den Index, und wenn ein besseres Modell kommt, wird nur das Modell getauscht.